

Selon McKinsey (cité par IBM Think), 35 % de ce que les acheteurs achètent sur Amazon vient des recommandations produit. Un moteur de recommandation est la plateforme d'apprentissage automatique derrière ce chiffre : il analyse les données d'usage et les transforme en suggestions personnalisées. Ces suggestions améliorent la conversion et les ventes pour chaque client. Cet article explique le fonctionnement d'un moteur de recommandation et compare le filtrage collaboratif, le filtrage par contenu et les approches hybrides avant d'aborder l'apprentissage profond et la factorisation matricielle.
Qu'est-ce qu'un moteur de recommandation ?
Définition : un moteur de recommandation prédit ce qu'un utilisateur voudra ensuite
A moteur de recommandation est un logiciel qui prédit l'article qu'un utilisateur a le plus de chances de vouloir ensuite. Il sait analyser les données sur les préférences d'un utilisateur et sur le contenu des articles, puis recommander les meilleures correspondances. La même idée apparaît sous les noms de système de recommandation ou de recommandeur. Derrière chaque recommandation se trouve un modèle d'apprentissage automatique qui apprend des schémas à partir de données passées pour délivrer des suggestions personnalisées en temps réel. Les équipes marketing et produit s'appuient sur cette analyse pour améliorer l'engagement et la pertinence de la personnalisation à grande échelle.
Les données derrière : signaux explicites et signaux implicites
Tout moteur se nourrit de deux types de données. Les données explicites sont ce que les utilisateurs déclarent eux-mêmes : notes, mentions j'aime, commentaires et avis. Les données implicites sont ce qu'ils révèlent par leur comportement : parcours de navigation, événements de panier, clics, achats passés et requêtes de recherche (IBM Think).
Le signal implicite, comme l'historique de recherche et de navigation, domine tous les moteurs en pratique, parce que les utilisateurs notent très peu d'articles mais en consultent beaucoup. Les données issues des réseaux sociaux peuvent ajouter du contexte tout en soulevant des questions de confidentialité. Le piège est le bruit : un clic n'est pas une préférence et seule une analyse soignée sépare l'intérêt réel du geste accidentel. Un bon moteur pondère les signaux selon leur force et affine sa représentation des préférences au fil du temps. Un achat pèse plus qu'une page vue.
Le saviez-vous ?
Selon McKinsey (cité par IBM Think), 35 % de ce que les acheteurs achètent sur Amazon vient des recommandations produit et 80 % de ce que les spectateurs regardent sur Netflix vient de suggestions algorithmiques.
Où vous en croisez déjà : Amazon et Netflix
Vous croisez un moteur de recommandation chaque fois qu'Amazon affiche « les clients ont aussi acheté » ou qu'un écran d'accueil de streaming se remplit de titres. McKinsey, cité par IBM Think, attribue aux recommandations 35 % des achats sur Amazon et 80 % du visionnage sur Netflix. Netflix chiffre l'effet combiné de la personnalisation et des recommandations à plus d'un milliard de dollars par an de revenu conservé (Gomez-Uribe et Hunt, ACM Transactions on Management Information Systems, 2015). Pour un distributeur ou un service de médias, le moteur est une infrastructure de revenu et non un widget cosmétique.
Comment fonctionne un moteur de recommandation : la chaîne en trois étapes
Étape 1 : la génération de candidats resserre le catalogue
Noter chaque article pour chaque utilisateur en temps réel est impossible à grande échelle, pour n'importe quel moteur. La génération de candidats règle ce problème en réduisant vite le catalogue. Dans le guide d'apprentissage automatique de Google, le système part d'un corpus énorme et produit un sous-ensemble bien plus petit. YouTube ramène des milliards de vidéos à quelques centaines ou milliers. Des méthodes peu coûteuses suffisent ici : plongements vectoriels, recherche vectorielle et listes de popularité. Les règles d'association en sont un exemple. Un moteur peut exécuter plusieurs de ces techniques en parallèle puis fusionner les présélections.
Étape 2 : le scoring classe les candidats avec un modèle d'apprentissage automatique
La deuxième étape applique un modèle plus lourd à la présélection. Le scoring peut se permettre des variables plus riches, historique de l'utilisateur, attributs de l'article et contexte, parce que le sous-ensemble est petit. Des algorithmes comme le gradient boosting ou les réseaux de neurones remplissent ce rôle. Le modèle utilise chaque variable pour analyser le contexte et estime la probabilité que l'utilisateur clique ou achète chaque candidat. Le moteur ne garde ensuite qu'une dizaine d'articles à afficher. C'est là que l'apprentissage automatique justifie son coût : un modèle précis sur quelques centaines d'articles plutôt qu'un modèle grossier sur des millions. La justesse compte surtout à cette étape et le modèle continue de s'améliorer avec de nouvelles données d'entraînement.
Étape 3 : le reclassement applique les contraintes métier, la diversité et la fraîcheur
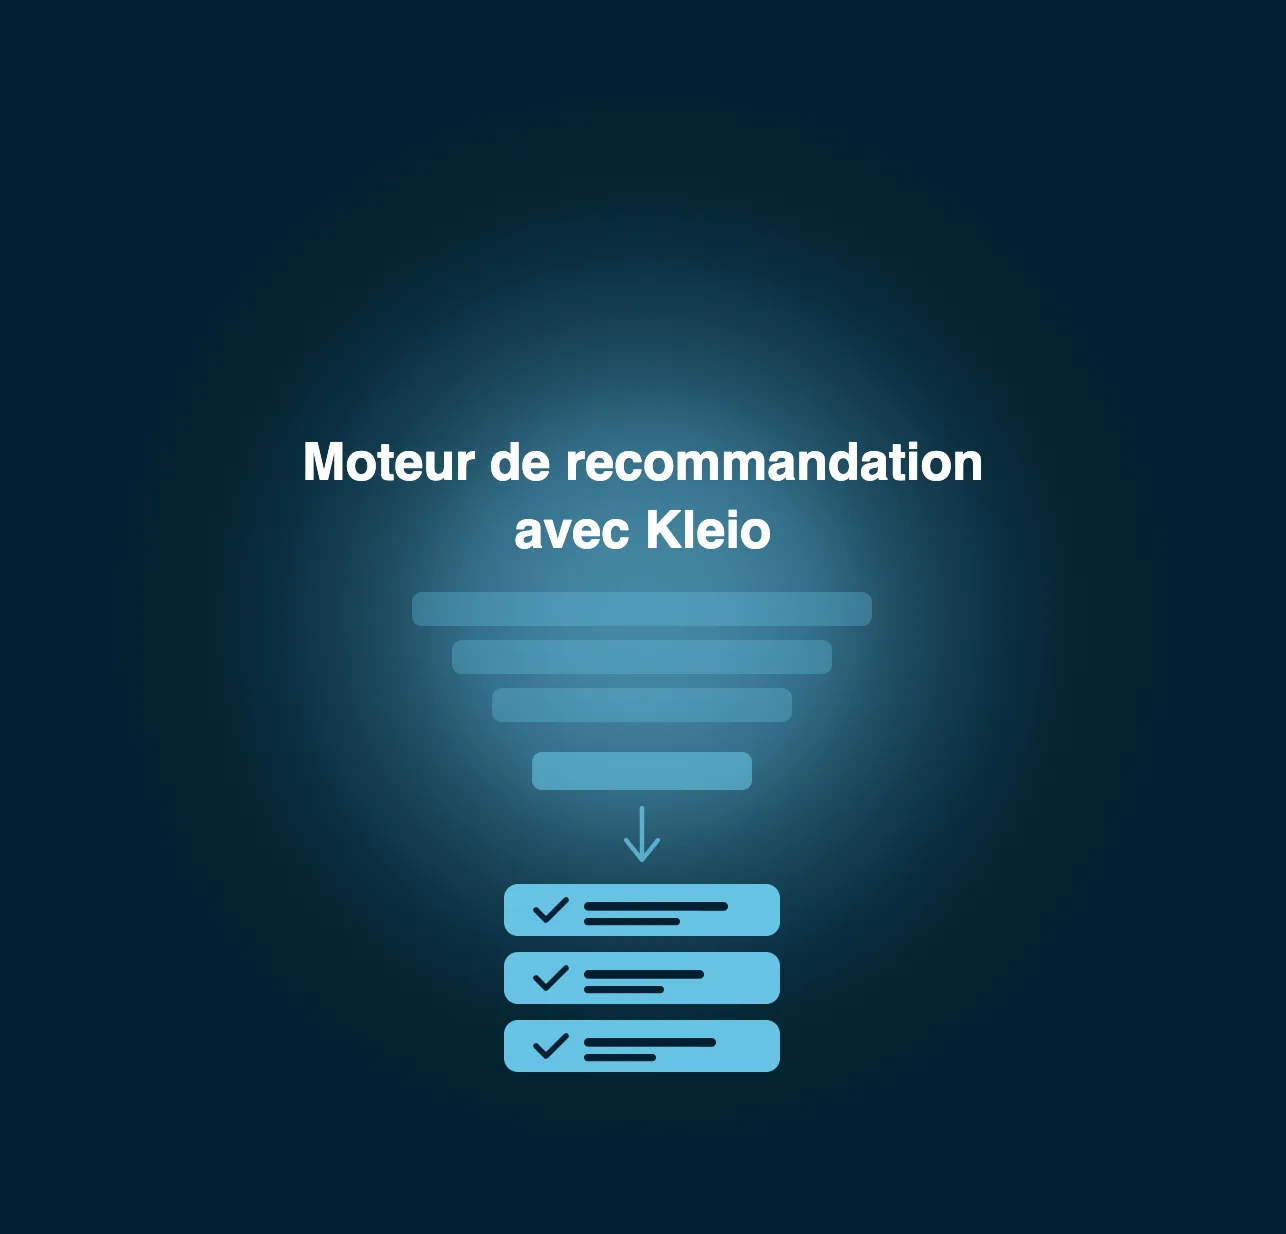
Le reclassement est la dernière étape de la chaîne et ajuste la liste notée avec des contraintes qu'un modèle seul ne capture pas. Il retire les articles que l'utilisateur a explicitement rejetés et met en avant les contenus plus récents. Il impose aussi de la diversité pour que dix produits quasi identiques ne remplissent pas la page. Les règles métier entrent ici également : niveaux de stock, marge et exclusions. Le schéma ci-dessous montre l'entonnoir complet. Un modèle peut être juste et produire quand même une mauvaise page sans cette dernière couche. Chaque signal de préférence peut opposer son veto à un candidat ici. Les équipes ajoutent souvent cette étape en dernier, alors que c'est elle qui décide de l'expérience utilisateur.
L'entonnoir ci-dessus explique aussi pourquoi les méthodes peu coûteuses passent devant et les modèles coûteux derrière.
Types de moteurs de recommandation et algorithmes
Filtrage collaboratif : apprendre des utilisateurs similaires
Le filtrage collaboratif recommande les articles qu'ont aimés des utilisateurs similaires et prend les préférences passées comme ressource principale. Si deux utilisateurs ont noté dix films de la même façon, le moteur suggère à l'un ce que l'autre a adoré. C'est une méthode qui n'exige aucune connaissance du contenu : seulement l'historique d'interaction entre utilisateurs et articles. C'est sa force et sa faiblesse. Avec peu de données elle échoue, surtout pour les nouveaux utilisateurs.
Filtrage par contenu : rapprocher les attributs des articles des préférences
Le filtrage par contenu compare les caractéristiques d'un article à un profil utilisateur. Un lecteur qui termine trois articles de blog sur la science des données en reçoit d'autres sur les mêmes sujets. Il fonctionne sans les autres utilisateurs et gère bien les articles nouveaux. Son coût est une bulle de préférences étroite : le moteur continue de servir la même chose et surprend rarement.
Systèmes de recommandation hybrides
A système de recommandation hybride est une technique guidée par les données qui combine signaux collaboratifs et signaux de contenu. Les caractéristiques de contenu couvrent la période de démarrage à froid, puis les signaux collaboratifs prennent le relais à mesure que les interactions s'accumulent. La plupart des systèmes en production sont hybrides sous une forme ou une autre et beaucoup combinent plus de deux approches. La question de conception n'est pas de savoir s'il faut mélanger les approches mais comment les pondérer à mesure que les données croissent. Chaque équipe devrait consigner ses pondérations et les réexaminer lors d'une évaluation régulière.
Factorisation matricielle et la leçon du Netflix Prize
La factorisation matricielle est une technique précise qui compresse l'immense matrice utilisateurs-articles en petits vecteurs de facteurs latents. Un utilisateur et un article correspondent quand leurs vecteurs pointent dans la même direction. La méthode est devenue célèbre avec le Netflix Prize, le concours ouvert organisé par Netflix de 2006 à 2009, doté d'un million de dollars pour toute équipe qui améliorerait son algorithme Cinematch de 10 %. Une équipe a franchi la barre. Netflix n'a pourtant jamais mis la solution gagnante complète en production. Ses propres ingénieurs en ont donné la raison : le gain de justesse mesuré hors ligne ne justifiait pas l'effort d'ingénierie nécessaire pour faire tourner ces modèles en conditions réelles (Netflix Technology Blog, « Netflix Recommendations: Beyond the 5 Stars », 2012). La leçon pour qui construit un moteur : le meilleur score hors ligne n'est pas automatiquement le meilleur modèle en production.
Apprentissage profond et modèles à deux tours
En apprentissage profond , des réseaux de neurones qui apprennent des représentations remplacent les variables construites à la main. L'architecture à deux tours utilise un réseau pour les utilisateurs et un pour les articles. Elle place les deux dans le même espace de plongement. La récupération devient alors une recherche rapide de plus proches voisins et gagne en performance à l'échelle. Parce que les tours acceptent des variables et pas seulement des identifiants, elles aident sur les utilisateurs et les articles nouveaux. La même technique alimente les modèles de langage qui lisent les descriptions d'articles et affinent la correspondance. Le traitement du langage lit descriptions et métadonnées comme le genre ou les étiquettes musicales, pendant que les modèles séquentiels suivent l'ordre des interactions. Les tendances actuelles pointent vers l'apprentissage par renforcement, qui va plus loin en optimisant l'engagement de long terme plutôt que le clic suivant.
Quelle approche de moteur de recommandation convient à votre catalogue ?
La bonne approche dépend de vos données et non de la mode. Les algorithmes de recommandation et les approches de filtrage se distinguent surtout par la quantité de données historiques et d'interactions dont ils ont besoin. Quatre variables tranchent et vous donnent des enseignements utiles : taille du catalogue, signaux par article, fréquence d'achat et richesse des attributs. Des données de comportement denses favorisent le filtrage collaboratif ou l'apprentissage profond et une optimisation poussée du modèle de classement. Des fiches produit riches avec peu d'historique favorisent le filtrage par contenu. Des achats rares aux spécifications détaillées appellent un raisonnement sur les attributs et les contraintes. Selon les réponses, la meilleure technique change. Utilisez le diagnostic ci-dessous pour voir quelle approche correspond à votre catalogue et quel risque surveiller en premier.
Le diagnostic résume la logique ci-dessus. Les achats rares et détaillés éloignent des modèles classiques et rapprochent du raisonnement.
Bénéfices, cas d'usage et limites d'un moteur de recommandation
Bénéfices métier : revenu, conversion et engagement
De bonnes recommandations augmentent les taux de conversion et améliorent l'expérience client. McKinsey estime que la personnalisation peut faire progresser le revenu de 5 % à 15 % et les taux de conversion de 10 % à 15 % (cité par IBM Think). La même source rapporte que 76 % des clients se sentent frustrés quand ils n'obtiennent pas d'interactions personnalisées. Un moteur de recommandation contribue aussi à l'engagement et à la satisfaction : des suggestions pertinentes retiennent les visiteurs plus longtemps et les font revenir.
Conseil d'expert :
Ne jugez pas un moteur sur les seuls clics et ne vous fiez pas à un test A/B d'une seule semaine. Suivez les ventes par session et le taux de retour à côté du taux de clic, pour que le moteur ne puisse pas gagner en ne recommandant que des articles bon marché et populaires.
Cas d'usage : distribution et commerce en ligne
Dans la distribution, le moteur alimente les « produits similaires », les « fréquemment achetés ensemble » et les suggestions de panier. Il soutient la rétention et l'efficacité des dépenses publicitaires. Il améliore aussi le panier moyen en montrant des articles complémentaires au bon moment. Les recommandations sur les pages catégories aident les acheteurs qui arrivent sans idée précise et améliorent l'expérience d'ensemble sur les sites marchands. La qualité des données produit décide du résultat : des champs manquants donnent un filtrage par contenu faible.
Cas d'usage : streaming et plateformes de contenu
Les services de streaming classent les catalogues de films et de vidéos pour chaque spectateur et trient titres ou morceaux par genre. Le service attribue l'essentiel de son visionnage aux recommandations (80 %, McKinsey via IBM Think). Le moteur optimise ici le temps de visionnage et la satisfaction sur un très grand catalogue, avec des données implicites abondantes. C'est précisément cette abondance qui fait si bien fonctionner le filtrage collaboratif et l'apprentissage profond dans ce contexte.
Comment mesurer un moteur de recommandation
Ce panorama des métriques compte parce que les usages diffèrent. Les métriques hors ligne comme le RMSE ou la précision comparent les prédictions aux journaux d'interactions passées. Les métriques en ligne mesurent ce que les utilisateurs font vraiment : taux de clic, conversion et ventes par session. Les gains hors ligne se transposent souvent mal en production, comme l'ont montré plusieurs travaux et le Netflix Prize. Menez des expériences contrôlées avant tout déploiement et traitez le score hors ligne comme un filtre et non comme une preuve.
Les métriques hors ligne comme le RMSE et la précision filtrent les modèles à moindre coût, pendant que le test A/B en ligne donne la vraie réponse sur la conversion et les ventes.
Démarrage à froid et données clairsemées
Le problème du démarrage à froid apparaît quand le système dispose de trop peu de données, surtout pour les nouveaux utilisateurs (IBM Think). La rareté des données en est le cousin : la plupart des utilisateurs laissent un historique minuscule à l'échelle du catalogue, donc la matrice est presque vide. Les remèdes courants sont les caractéristiques de contenu, les replis sur la popularité et quelques questions d'accueil. Chaque technique réduit le problème sans le supprimer.
Biais, confidentialité et explicabilité
Tout moteur amplifie ce qui est déjà populaire et peut enfermer les utilisateurs dans une bulle de filtres. Les services financiers et les autres secteurs régulés y sont les plus exposés, puisque chaque signal de préférence peut porter un risque. Ils dépendent aussi de données personnelles : les règles de confidentialité limitent ce que l'on collecte et la durée de conservation. Enfin, un modèle opaque est difficile à expliquer à un client ou à un régulateur, donc consignez quels signaux déclenchent une recommandation avant que quiconque ne pose la question. Surveillez la diversité et fixez une politique claire de partage des données avant la mise en service.
Là où les moteurs classiques cassent : catalogues à forte implication et Kleio
Pourquoi l'historique d'interaction s'épuise sur les achats rares et coûteux
Les moteurs classiques supposent un comportement répété. On achète un livre chaque mois mais un logement, une croisière ou une voiture une fois tous les plusieurs ans. Les données par article restent minuscules et la matrice utilisateurs-articles est presque vide. Pire, environ 60 % des acheteurs ne savent pas ce qu'ils veulent au départ (Kleio). Un modèle entraîné sur des clics passés a peu de matière et la matrice reste clairsemée. Le tableau ci-dessous résume l'écart.
Les moteurs classiques s'appuient sur le comportement passé et souffrent du démarrage à froid. Le raisonnement sur les attributs et le contexte convient aux achats rares à forte implication comme le voyage, l'immobilier et l'automobile. Notre blog traite le versant acheteur : lire la suite sur l' agentic discovery pour la vue côté acheteur.
De la prédiction comportementale au raisonnement sur attributs, contraintes et contexte
Pour les achats à forte implication, le moteur doit raisonner et non seulement prédire. Il lit les attributs produit, le prix, la disponibilité et les relations entre produits. Il pose des questions à l'acheteur et met à jour sa réponse à chaque réaction pour faire émerger de nouveaux enseignements sur ses préférences. Un refus n'est pas du bruit : il amène le moteur à réviser la recommandation suivante. Le moteur de recommandation cesse alors d'être un modèle de classement pour devenir une conversation guidée qui qualifie le besoin au fil de l'échange.
Comment le Knowledge Engine de Kleio alimente les recommandations produit
Kleio est une plateforme d'Agentic Commerce pour les ventes complexes à forte valeur. Son Knowledge Engine unifie données produit, documents et mémoire de conversation dans trois stores dédiés. C'est le problème de données résolu en premier : les agents répondent à partir de données approuvées avec 99 % de précision, des réponses en moins de 3 secondes et aucune hallucination. Une Triple Business Ontology couvre sept secteurs, du voyage à l'immobilier et à l'automobile. Les projets passent du lancement à la production en 8 à 12 semaines. Découvrez le fonctionnement du Knowledge Engine .
À quoi cela ressemble en production : le réseau Orpi
Orpi exploite Kleio sur 1 250 agences et 8 000 conseillers. La préférence de chaque acheteur façonne la sélection. La plateforme est passée en production en trois mois. Les acheteurs décrivent un projet flou, le moteur de recommandation fait remonter les biens correspondants et transmet aux conseillers des leads qualifiés avec le contexte déjà capté. Voir l' étude de cas Orpi pour les résultats complets.