

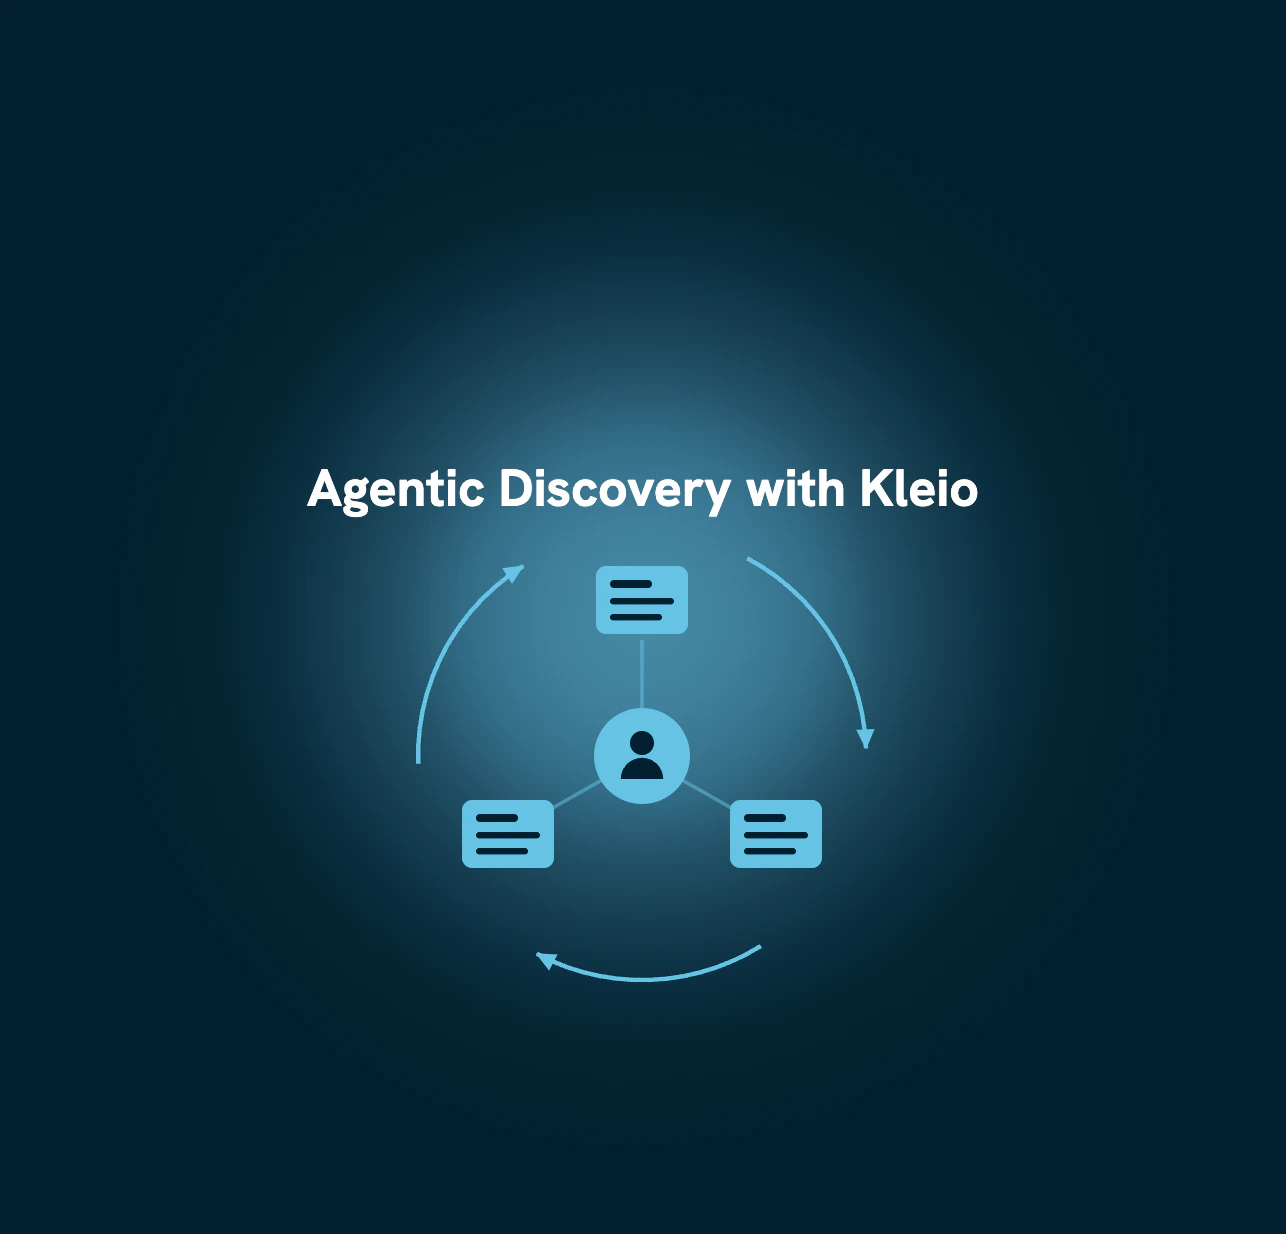
La plupart des acheteurs des catégories à forte implication n'arrivent pas en sachant ce qu'ils veulent. Ils arrivent avec une aspiration : le sentiment qu'il faut déménager, renouveler une flotte, réserver quelque chose de mémorable ou se réapprovisionner avant une saison que personne ne sait prévoir précisément. Découverte agentique est l'usage d' agents IA autonomes pour construire la préférence que ces acheteurs n'ont pas encore, en leur mettant de vrais produits sous les yeux et en apprenant de chacune de leurs réactions. Ce n'est pas une barre de recherche plus rapide, et cette distinction décide si votre catalogue convertit la majorité indécise ou sert seulement la frange déjà décidée. Ce guide explique ce qu'est la découverte agentique, pourquoi la recherche conversationnelle déçoit au stade de la découverte, comment la boucle fonctionne réellement, et ce que vos produits données doivent permettre pour la soutenir.
Qu'est-ce que la découverte agentique ? Définition, périmètre, et ce qu'elle n'est pas
La découverte agentique en une phrase
Découverte agentique est le processus par lequel des agents IA autonomes aident un acheteur à construire une préférence en explorant des produits réels et en y réagissant, par opposition à la recherche agentique, qui exécute une préférence qu'il possède déjà. La différence tient à l'objectif, pas à l'interface. Un système de recherche suppose que la réponse existe et qu'il suffit de la trouver : son travail est la récupération et le classement. Un système de découverte suppose que la réponse doit être construite : son travail est d'exposer les arbitrages, de présenter des options concrètes auxquelles l'acheteur peut réagir, et d'affiner son modèle de cet acheteur après chaque réaction, y compris les refus. Les deux peuvent passer par une conversation, les deux peuvent appeler le même catalogue, et ils produisent pourtant des résultats différents, parce que l'un sert une intention qui existe déjà et que l'autre la crée. Pour une direction commerciale, ce n'est pas une querelle de vocabulaire : cela décide quelle moitié de votre trafic vous êtes réellement équipé pour convertir.
Découverte agentique et recherche agentique : la distinction qui compte
La thèse dominante du commerce IA est compacte : exposez votre catalogue via des couches de MCP ou un jeu d'outils, laissez l'acheteur décrire ce qu'il veut en langage naturel, et laissez un agent faire le reste. Pour une intention réellement forte, cette thèse est juste. « Rebooke le même trajet », « recommande le même jeu de pièces », « trouve-moi le 8h40 pour Lyon » sont des problèmes de récupération, et un agent doté d'une API y bat toutes les autres interfaces. La thèse s'effondre sur le présupposé qu'elle enfouit : que l'acheteur se présente avec une préférence formée, qu'il suffirait d'exécuter. Dans le voyage, l'immobilier, la distribution automobile, l'hôtellerie, le négoce et les équipements à forte valeur, ce présupposé tient rarement, et aucune qualité de raisonnement ne sauve un agent à qui l'on demande de retrouver une réponse que l'acheteur n'a pas encore formée.
Trois autres sens que vous croiserez dans les résultats de recherche
Le terme est surchargé, et une recherche sur « agentic discovery » renvoie trois choses sans rapport avec celle qui compte pour votre chiffre d'affaires. En ingénierie logicielle, la découverte agentique de ressources désigne les travaux de spécification ouverte qui permettent à un agent de localiser et de vérifier des outils, des compétences ou d'autres agents dans un cloud distribué. En recherche, Microsoft Discovery et des travaux académiques comparables font collaborer des agents pour formuler des hypothèses et lancer des simulations en science des matériaux ou en découverte de médicaments. En sécurité, les éditeurs emploient le terme pour l'inventaire de toutes les identités non humaines d'un environnement, afin qu'aucun agent autonome ne fonctionne sans propriétaire ni avec des privilèges excessifs. Les trois sont réels, aucun ne concerne un acheteur qui choisit votre produit, et c'est pourquoi tant de pages positionnées sur ce mot-clé s'adressent à des développeurs ou à des équipes sécurité plutôt qu'aux responsables de la conversion.
Pourquoi on ne peut pas amener la plupart des acheteurs à décider par la recherche
La majorité à intention faible
Environ 60 % des acheteurs des catégories que nous servons ne savent pas au départ ce qu'ils veulent, et les données derrière ce chiffre ne laissent guère de place au doute. Dans l'automobile, environ 60 % des acheteurs démarrent sans marque ni modèle précis en tête — d'où le nom que le secteur a donné à cette première étape : la phase de découverte. Dans l'immobilier, le déclencheur est émotionnel bien avant d'être un cahier des charges : un primo-accédant ressent une aspiration à la stabilité ou à l'appartenance des mois avant de pouvoir énoncer un budget, un quartier ou un nombre de pièces, et ces paramètres concrets émergent pendant la recherche plutôt qu'avant elle. Dans le voyage, la plateforme dominante du secteur a elle-même concédé le point publiquement, en reconnaissant que ce qu'elle avait toujours bien fait, c'était le dernier kilomètre de la recherche à la réservation, et que le problème réellement difficile était d'aller chercher le client plus tôt, pendant qu'il cherchait encore ce qu'il voulait. Les travaux sur le parcours de décision du consommateur ajoutent un détail qui met à mal la plupart des modèles de tunnel : l'ensemble considéré s'élargit souvent pendant l'évaluation active, au lieu de se resserrer vers une réponse présélectionnée.
Le paradoxe du filtre
Voici le piège structurel qui rattrape la recherche conversationnelle dans ces catégories. Quand l'intention est forte, le langage naturel est une moins bonne interface qu'un filtre : décrire une préférence en une phrase et attendre qu'un agent l'analyse est plus lent que trois clics sur le prix, les dates et la localisation. Quand l'intention est faible, un meilleur analyseur n'aide pas davantage, puisqu'il ne peut pas renvoyer une réponse que l'acheteur n'a pas encore formée. Une façon plus fluide de demander « qu'est-ce que je veux au juste ? » ne récupère rien d'utile. Une couche de recherche purement conversationnelle atterrit donc dans un entre-deux inconfortable : trop lente pour celui qui a décidé, trop superficielle pour celui qui hésite. Cela reste vrai indépendamment de la qualité des modèles — raison pour laquelle la promesse de la recherche sémantique déçoit depuis des années dans ces catégories, alors même que les modèles n'ont cessé de progresser.
Traduire une intention n'est pas la créer
Regardez de près ce que font réellement la plupart des fonctions sémantiques. Le schéma dominant, y compris chez les plus grandes plateformes, consiste à prendre une phrase et à la projeter sur des filtres qui existaient déjà. Tapez « une villa familiale avec piscine près de la plage » et le système applique automatiquement les filtres correspondants. C'est réellement utile, et c'est très exactement de la traduction d'intention : cela sert une préférence que l'acheteur possède déjà et ne fait rien pour créer celle qui lui manque. L'argument adverse le plus fort mérite d'être entendu, car il est réel. Les plateformes rapportent que les utilisateurs sont passés de requêtes à un seul mot-clé à des formulations plus riches, de type découverte, avec un engagement en hausse. Deux choses méritent d'être distinguées. L'engagement n'est pas une décision assurée, aboutie et à forte valeur, et les études de cas d'éditeurs publient rarement l'écart de conversion face à une référence de filtres solide. Plus important encore, faire remonter davantage d'un catalogue existant en réponse à une requête plus riche reste de la récupération. Cela élargit le tunnel sans aider quiconque à construire une préférence qu'il n'avait pas en arrivant.
Les préférences se construisent, elles ne se retrouvent pas
La thèse de l'automatisation hérite d'un modèle ancien et largement faux de l'acheteur : un agent rationnel porteur de préférences stables, qu'il suffirait de révéler. Des décennies de recherche sur le consommateur disent presque l'inverse. Bettman, Luce et Payne ont établi en 1998 que le consommateur manque fréquemment de préférences bien définies en mémoire et les construit pendant la décision elle-même, avec des stratégies qui dépendent de la tâche et de la façon dont les options lui sont présentées. La préférence est un résultat du processus de décision, pas une donnée d'entrée. C'est aussi pourquoi davantage de choix peut dégrader le résultat : dans l'étude de terrain bien connue d'Iyengar et Lepper, les clients confrontés à un large assortiment achetaient nettement moins que ceux à qui l'on en montrait peu. Des travaux méta-analytiques ultérieurs ont montré que l'effet dépend de modérateurs plutôt qu'il ne soit universel ; la lecture rigoureuse n'est donc pas que moins de choix vaut toujours mieux, mais qu'un acheteur incapable d'évaluer un ensemble large diffère ou abandonne. Un catalogue brut derrière une interface conversationnelle, c'est exactement cet ensemble large, présenté à travers une expérience de navigation pire que celle qu'elle remplace.
Le saviez-vous ?
Les secteurs que sert Kleio exposent couramment plus de 100 millions de variantes et de choix. Quand un acheteur ne peut pas évaluer un ensemble aussi vaste, il ne choisit pas avec plus de soin : il diffère ou abandonne. Resserrer l'ensemble n'est pas une limite de l'interface, c'est le produit.
Si les préférences se construisent, le vrai rôle du système est d'aider à les construire. C'est ce pour quoi les systèmes de recommandation par critique ont été conçus : l'acheteur part d'un exemple concret, y réagit (« moins cher », « comme celui-ci mais plus près du centre »), et le modèle affine son estimation au fil de plusieurs cycles. La littérature est explicite : cette approche compte surtout dans les domaines à fort risque et de premier achat, où l'utilisateur n'a au départ aucune préférence arrêtée. L'immobilier, l'automobile et le voyage en sont les cas d'école, pas les cas limites.
Comment fonctionne réellement la découverte agentique, étape par étape
Étape 1 : amorcer le modèle de l'acheteur avec des a priori
La boucle ne démarre pas de zéro. Un moteur de la recommandation produit digne d'être déployé amorce son modèle d'acheteur à partir de ce que vous détenez déjà : fiches CRM, appartenance à un segment, transactions passées, canal d'arrivée. Ces a priori ne sont pas traités comme des faits : ce sont des croyances assorties d'un score de confiance et d'une étiquette d'origine, pour que le système distingue ce que l'acheteur a dit, ce qu'il a démontré en réagissant, et ce qui a été hérité d'une moyenne de segment. La personnalisation commence dès le premier tour plutôt qu'après dix questions, et le profil reste auditable — ce qui compte dès qu'une revue vie privée ou conformité demande d'où vient telle hypothèse.
Étape 2 : présenter un ensemble restreint, varié et lisible de produits réels
Plutôt que de renvoyer une longue liste classée, le moteur présente un petit ensemble choisi pour couvrir l' espace de paramètres de votre catalogue: différents niveaux de prix, différents arbitrages, différentes formes d'un même besoin. L'objectif n'est pas de viser juste du premier coup, mais de donner à l'acheteur quelque chose de concret contre quoi se positionner. Un acheteur incapable d'énoncer un budget vous dira pourtant, instantanément et de façon fiable, qu'une option lui semble trop chère et qu'une autre est si peu chère qu'elle le rend méfiant. Cette réaction porte davantage de données structurées sur sa préférence que n'importe quelle question que vous auriez pu lui poser.
Étape 3 : apprendre de chaque réaction, refus compris
C'est l'étape qui sépare la découverte de la recherche. Un refus n'est pas un résultat raté, c'est le signal le plus informatif de la session. Quand l'acheteur écarte une option, le moteur ne se contente pas de la retirer : il déduit quel attribut a déclenché le refus, révise sa croyance sur cet attribut, et réinterroge le catalogue à partir du modèle mis à jour. L' Agentic Discovery Engine de Kleio est bâti exactement autour de ce comportement : le catalogue expose son espace de paramètres, et un « non » le réinterroge plutôt que de clore la conversation. Sur les déploiements en production, cette boucle tourne avec 99 % de justesse avec des temps de réponse sous les 3 secondes de temps de réponse, assez vite pour que l'acheteur la vive comme une conversation et non comme une succession de chargements de page.
Étape 4 : réunir mémoire structurée et mémoire libre dans un seul profil
Paramètres durs et signaux faibles ont leur place au même endroit. Une fenêtre de livraison, un budget maximal et une contrainte de compatibilité sont structurés ; « un endroit où mes parents peuvent venir facilement », « rien qui fasse trop corporate » et « je me suis fait avoir la dernière fois sur les délais » ne le sont pas, et un filtre ne sait exprimer ni les uns ni les autres. Un store de mémoire probabiliste contient les deux : il ajoute des croyances, les révise quand l'acheteur se contredit, et les efface quand elles cessent de s'appliquer, chacune assortie d'un score de confiance. C'est aussi ce qui permet au profil de survivre à un parcours étalé sur des semaines et impliquant plusieurs interlocuteurs, au lieu de repartir de zéro à chaque session et de reposer à un prospect la même question de qualification pour la troisième fois.
Étape 5 : convertir ou transmettre avec tout le contexte
La boucle se termine par une action plutôt que par un rapport : un achat, une réservation, une demande de devis, ou une transmission à un conseiller humain avec tout ce que le moteur a appris. Cette qualité de transmission est souvent le vrai produit. Une équipe commerciale qui reçoit un lead avec la préférence construite attachée — options écartées, contraintes confirmées, arbitrage ouvert — convertit tout autrement que celle qui reçoit un formulaire avec un nom et un e-mail. Dans une catégorie où le conseiller intervient, le même moteur tourne derrière le comptoir comme copilote, si bien que l'humain et l'agent travaillent sur un seul profil plutôt que deux.
Où se situent réellement MCP, UCP et les protocoles d'agents
Rien de tout cela n'est un argument contre les agents ou contre les protocoles. MCP et d' UCP sont réels et utiles, et Kleio les implémente nativement pour que votre catalogue puisse être exposé aux moteurs de recherche IA externes comme canal de distribution. Mais ce sont des tuyaux. Un protocole expose un catalogue ; il ne sait pas comment aider quelqu'un à désirer ce qu'il n'avait pas imaginé. Sans une véritable maîtrise de la conversation et du catalogue qui la sous-tend, un agent automatise, plus vite, une recherche que l'acheteur n'était pas équipé pour mener. L'avantage défendable n'a jamais été le protocole, que tout le monde finira par avoir. C'est l'expérience de découverte bâtie par-dessus, et le modèle de l'acheteur que cette expérience encode.
Conseil d'expert
Si votre catalogue ne peut être que filtré, et non pas objet de réactions, vous optimisez pour les acheteurs qui savent déjà ce qu'ils veulent. L'exposer via MCP le rend accessible aux agents ; cela ne le rend pas découvrable par un acheteur indécis. Ce sont deux chantiers différents.
Où la découverte agentique crée du chiffre d'affaires, secteur par secteur
Voyage et hôtellerie
Les voyageurs partent rarement d'un itinéraire. Ils partent d'une fenêtre de dates, d'un budget incertain et d'une intuition sur le type de séjour qu'ils veulent. Les clients de Kleio décrivent le basculement sans détour : Christophe Jacquet, CEO de Havas Voyages, fait état d'un déploiement d' agentic commerce qui a déjà dopé la génération de leads grâce à une expérience conversationnelle engageante et personnalisée, et Bertrand Bonnefoi, directeur marketing de Selectour, décrit le même mouvement comme une accélération du secteur vers l'ère de l'agentic commerce.
Immobilier
Des milliers de biens, des critères mouvants et une décision chargée d'émotion font de l'immobilier le cas le plus net de construction de préférence. Guillaume Martinaud, président d'Orpi, parle d'un outil de rupture qui exploite l'immense richesse des données du réseau sur 1 250 agences, un cas détaillé plus loin dans ce guide. L'acquéreur découvre ce qu'il veut vraiment en réagissant à de vraies annonces, et le conseiller hérite d'une préférence qualifiée plutôt que d'une liste de souhaits.
Distribution automobile
Environ 60 % des acheteurs automobiles démarrent sans marque ni modèle en tête, et l'espace de configuration se compte en millions de combinaisons valides une fois les finitions, les options et les conditions de financement prises en compte. Un moteur qui raisonne sur la compatibilité, la disponibilité et les réactions de l'acheteur resserre cet espace en quelques tours et route une correspondance qualifiée vers la concession la plus proche, au lieu de laisser l'acheteur filtrer un catalogue qu'il n'est pas encore en mesure d'évaluer.
Négoce et industrie
L'acheteur professionnel semble différent en surface et se comporte pourtant de la même façon. Une décision de réapprovisionnement ou un appel d'offres sur cahier des charges technique suppose toujours un vaste espace de paramètres, un budget contraint et des arbitrages que l'acheteur ne sait pas pleinement formuler d'emblée. La découverte agentique consiste ici à proposer des configurations viables, à apprendre de ce qui est écarté et à appliquer de l'automatisation à un processus qui, sinon, s'étale entre les achats, l'ingénierie et commerciale sur plusieurs fils d'e-mails.
Assurance et énergie
Les besoins de protection ou de rénovation arrivent flous presque par définition. Un particulier sait que quelque chose ne va pas avec sa facture de chauffage, pas quel système il devrait installer. Un moteur qui présente des options concrètes et chiffrées et apprend des réactions transforme ce besoin flou en lead prêt à être devisé — la même discipline appliquée à un autre catalogue.
Votre catalogue est-il prêt pour la découverte agentique ? Un diagnostic
Votre catalogue sait-il exposer son espace de paramètres ?
La plupart des catalogues sont faits pour être filtrés, pas pour qu'on raisonne dessus. Ils répondent à « montre-moi tout ce qui est sous 500 » et ne savent pas répondre à « quels sont les arbitrages significatifs dans cette gamme de prix ». Un moteur qui construit une préférence a besoin de voir la forme de l'espace : quels attributs varient, quelles combinaisons sont valides, où se situent les regroupements. Si votre catalogue ne sait renvoyer qu'une liste filtrée, vous êtes équipé pour la minorité décidée et structurellement aveugle à tous les autres.
Des attributs structurés plutôt que des descriptions rédigées
Des spécifications enfouies dans des paragraphes de vente doivent être déduites plutôt que lues, et la déduction échoue en silence. Dimensions, règles de compatibilité, paliers tarifaires et disponibilités ont leur place dans des champs explicites et lisibles par machine, avec des noms cohérents, des unités explicites et des identifiants stables. C'est généralement le correctif le moins coûteux de cette liste, parce que la donnée existe presque toujours quelque part dans l'organisation, simplement pas dans un format exploitable par un agent. C'est aussi celui qui plafonne silencieusement tout le reste, puisque la qualité des métadonnées fixe le plafond de ce que peut faire n'importe quelle couche raisonnement .
Une mémoire qui survit à tout le parcours
Une décision à forte valeur se conclut rarement en une session. Elle s'étale sur des semaines, plusieurs appareils et plusieurs interlocuteurs, et elle change de forme en chemin. Un moteur sans mémoire persistante traite chaque interaction comme la première et repose des questions auxquelles l'acheteur a déjà répondu — précisément l'expérience qui érode la confiance dans un parcours porté par l'IA. Demandez-vous si vos systèmes savent transporter une préférence construite, et pas seulement un identifiant de session, d'une première visite anonyme à une conversation avec un conseiller trois semaines plus tard.
Un journal d'audit que vous pouvez réellement montrer
Chaque croyance ajoutée, révisée ou effacée doit être consignée, avec ce qui l'a déclenchée. Ce journal n'est pas seulement un artefact de conformité. C'est ainsi que vous réglez le moteur, que vous expliquez une recommandation à un acheteur qui la questionne, et que vous répondez à un régulateur ou à une équipe sécurité sans avoir à rétro-analyser le comportement d'un modèle après coup. Si vous ne pouvez pas reconstituer pourquoi le système a proposé ce qu'il a proposé, vous n'avez pas d' gouvernance
A low score on that grid is not a reason to stall a project. It is a punch list, and the next section covers what happens once it is addressed.
From Pilot to Production, Governance, Speed and Proof
The Governance Gap Behind Failed Agentic Projects
Enthusiasm is not the bottleneck; governance is. Gartner projects that 40% of agentic AI projects will be abandoned by the end of 2027, not because the technology fails, but because organizations cannot demonstrate a clear business outcome or control costs as capabilities scale past a pilot. That risk maps directly onto the gaps above: a catalog that cannot expose its parameter space produces recommendations nobody trusts, a memory layer that resets produces a journey nobody finishes, and an engine with no audit trail produces a compliance problem nobody budgeted for. The organizations that avoid this outcome assign clear ownership of data readiness as the first milestone rather than discovering it during a failed pilot review six months in.
Did You Know?
Gartner also finds that only 17% of organizations have deployed AI agents into production, while more than 60% plan to within two years, meaning most of the market is still building the data foundation this guide describes.
What Kleio's Knowledge Engine and Agentic Discovery Engine Change
Kleio's answer to that gap is the Knowledge Engine, three purpose-built stores for product, document and memory data, sitting behind a separate configuration and governance layer that every deployed agent has to pass through. The Agentic Discovery Engine runs on top of it and holds the loop described above: priors from your CRM, structured and free-form beliefs with confidence scores, reaction-based re-querying against your live catalog, and a live audit log of every change. Measured across production deployments, that combination delivers 99% accuracy and sub-3-second response times with a zero-hallucination design that answers only from approved data. Agentic Orchestration then deploys, versions and routes thousands of collaborating agents across the journey, while a Triple Business Ontology covering function, industry and customer means Travel is not treated like Automotive and Real Estate is not treated like Wholesale. The engine runs on your infrastructure, stays provider-agnostic, and works across web, mobile, conversational and advisor copilot surfaces.
Weeks, Not Months, the Orpi Case
Real estate network Orpi is the clearest proof that this moves fast. CEO Guillaume Martinaud committed publicly to a timeline most enterprise software projects would consider unrealistic, and the team delivered: "In three months, we kept our commitment: the platform is live, on Orpi.com and in each of our 1,250 agencies. It is a disruptive tool that leverages the immense richness of our data to better serve our clients and our 8,000 advisors, and positions Orpi where future buyers now make their first searches." That timeline is not an outlier in Kleio's model: enterprise deployments typically go live in 8 to 12 weeks from kickoff to production, against the multi-quarter timelines common with in-house builds, generalist delivery partners or point solutions stitched together after the fact. For a CEO or CRO weighing whether agentic discovery is worth the investment, that speed is often the deciding variable, because a slow deployment erodes the internal sponsorship a project needs to survive its first budget review.
Security and Compliance by Default
None of that speed comes at the expense of security. Kleio's infrastructure is SOC 2 compliant and CCPA compliant, hosted in a tenant-isolated environment, with per-operation, permission-scoped access control, automated access reviews and versioned configurations, so every agent action traces back to an approved policy. Sensitive fields are pseudonymized in flight before any external model call, and monitoring runs 24/7 to block inappropriate requests before they reach a customer. If your catalog, your data and your journey are ready for agentic discovery, the fastest way to find out is to watch an engine work through your own products.
See It On Your Own Data
See Agentic Discovery Run On Your Own Catalog
Kleio's Agentic Discovery Engine runs the loop on your own products: real options, real reactions, a preference built in a few turns. See what your undecided buyers would actually do.
Book a Demo