

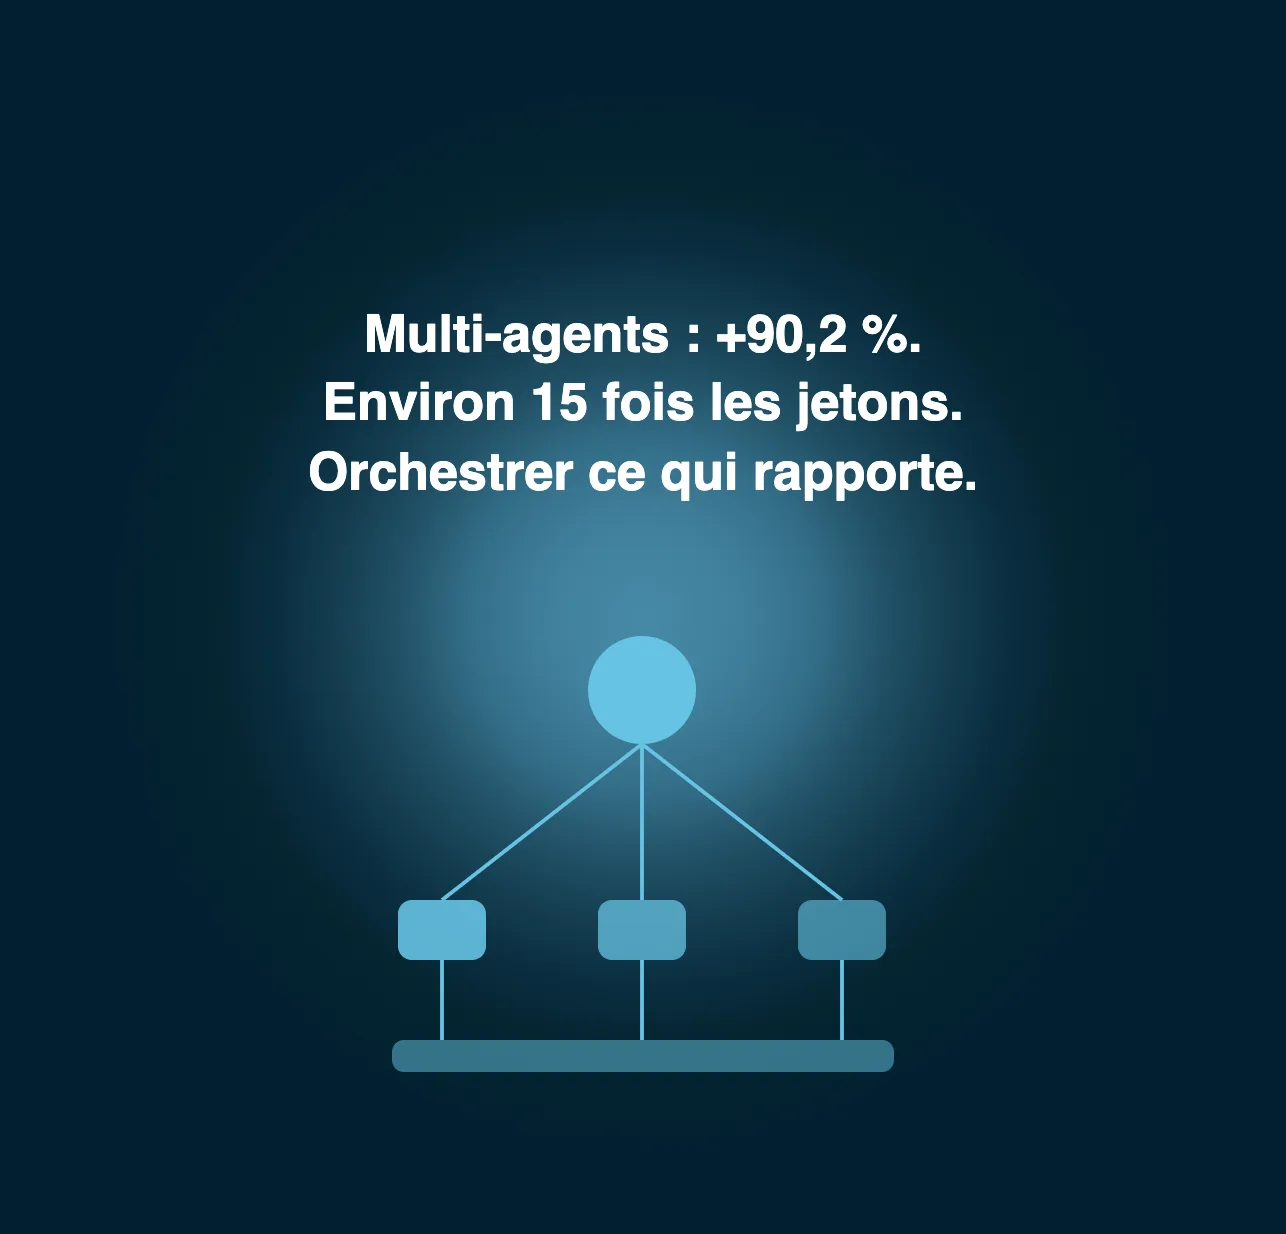
Un système multi-agents a dépassé un agent unique de 90.2 % à l’évaluation de recherche interne d’Anthropic, tout en consommant environ 15 fois les jetons d’une interaction de conversation. L’orchestration d’agents IA est la couche d’orchestration derrière ce résultat : un orchestrateur coordonne plusieurs agents IA sur des flux de travail complexes. Des agents spécialisés partagent une mémoire et se passent les tâches par une communication inter-agents que la couche de coordination contrôle. Ce guide montre quand l’orchestration multi-agents est rentable pour des systèmes d’entreprise et quels schémas d’orchestration d’agents conviennent à votre architecture et à votre risque.
Orchestration d’agents IA : ce que c’est et quand un agent unique suffit
Ce que signifie l’orchestration d’agents IA
L’orchestration d’agents IA est la coordination de plusieurs agents spécialisés pour qu’ils accomplissent ensemble un même flux de travail. Un orchestrateur tel qu’un agent gestionnaire décide quel agent agit ensuite et quel contexte partagé il reçoit. Dans les systèmes multi-agents il fait office de plan de contrôle sous supervision humaine. L’orchestration centralisée et l’orchestration concurrente acheminent chaque demande entre outils et données en temps réel, pour le service client ou la vente.
Des messages d’agent à agent portent chaque tâche. Des agents autonomes privés d’une telle coordination se comportent comme une discussion de groupe sans président de séance.
En quoi l’orchestration diffère d’un flux de travail et d’un agent unique outillé
Un flux de travail classique exécute une séquence d’étapes figée. Il convient aux remboursements et aux validations, là où le chemin est connu et où chaque exécution doit se comporter de la même façon. Une automatisation de ce type n’exige aucune décision autonome. Un agent unique outillé choisit ses propres étapes mais travaille seul dans une seule fenêtre de contexte. Il peut interroger une base de données ou créer un devis par une API sans aucun problème de coordination. Son comportement se prête à l’évaluation parce qu’un seul composant prend toutes les décisions.
L’orchestration commence quand plusieurs agents aux responsabilités distinctes doivent coopérer sur une même tâche. L’automatisation du flux peut subsister à l’intérieur et les flux complexes mêlent souvent les deux. Un flux figé peut traiter l’étape de paiement pendant que des agents traitent les questions ouvertes. L’Azure Architecture Center de Microsoft décrit trois niveaux de complexité : un appel direct au modèle, un agent unique outillé et l’orchestration multi-agents. Commencez par le niveau le plus bas qui résout le problème.
Ce que coûte la coordination en jetons
Anthropic a rapporté le gain et la facture dans le même article. En général une équipe retient le premier et oublie la seconde. Son système de recherche multi-agents, avec un modèle chef de file et des modèles sous-agents plus petits, a dépassé une référence à agent unique de 90.2 % lors d’une évaluation interne. Les agents ont consommé environ quatre fois les jetons d’une interaction de conversation et les systèmes multi-agents environ 15 fois. Sur le banc d’essai BrowseComp, la seule consommation de jetons expliquait 80 % de la variance de performance.
Le saviez-vous ?
Anthropic a constaté que les systèmes multi-agents sont rentables sur des tâches de valeur qui se parallélisent bien et dépassent une fenêtre de contexte. Le même article avertit qu’ils conviennent mal quand les agents dépendent les uns des autres à chaque étape.
Lisez ce résultat comme un signal de prix. Plus d’agents achètent plus de raisonnement et plus de travail parallèle. Chaque agent supplémentaire ajoute aussi des appels de modèle que vous payez à chaque exécution. L’orchestration a donc sa place sur les tâches où une meilleure réponse vaut plusieurs fois le coût d’une réponse de conversation.
Pourquoi l’intérêt des entreprises pour les systèmes multi-agents augmente
Gartner a enregistré une hausse de 1,445 % des demandes de clients sur les systèmes multi-agents entre le premier trimestre 2024 et le deuxième trimestre 2025. Le cabinet prévoit aussi que d’ici 2027 environ 70 % des systèmes multi-agents reposeront sur des agents aux responsabilités étroites. Des responsabilités étroites améliorent la précision mais augmentent la quantité de coordination que le système doit absorber sur l’ensemble d’une activité.
La demande et les taux d’échec progressent ensemble. Gartner prévoit aussi que plus de 40 % des projets d’IA agentique seront abandonnés avant la fin 2027, pour cause de coût et de valeur incertaine. Notre guide de l’ IA agentique traite ce risque du côté de la stratégie. Le présent guide reste sur l’architecture qui décide de la survie d’un système multi-agents.
Agent unique ou multi-agents : un sélecteur en cinq questions
Microsoft qualifie l’agent unique outillé de « choix par défaut souvent pertinent pour les cas d’usage en entreprise ». L’orchestration multi-agents ajoute un surcoût de coordination, de la latence et de nouveaux modes de défaillance. Elle gagne sa place quand un agent unique échoue sur la complexité du prompt ou la surcharge d’outils. Elle la gagne aussi quand des exigences de sécurité imposent des frontières distinctes par agent. Chaque exigence doit être explicite avant de construire.
Le sélecteur ci-dessous transforme ce conseil en décision. Répondez à cinq questions sur votre tâche. Vous obtenez un niveau recommandé et un schéma à tester en premier. Vous obtenez aussi un multiplicateur de jetons indicatif fondé sur les chiffres d’Anthropic.
Si l’outil recommande un agent unique, vous avez économisé de l’argent et une surface de défaillance. S’il recommande l’orchestration, les sections suivantes expliquent comment la coordination fonctionne.
Comment fonctionne l’orchestration multi-agents : rôles, routage, état partagé et passation
L’orchestrateur et les agents exécutants
L’ orchestrateur planifie la tâche et délègue chaque partie. Il peut être un agent gestionnaire animé par un modèle de langage ou un programme déterministe doté de sa propre logique. Les agents exécutants accomplissent chacun une tâche délimitée. Un agent tarification lit le catalogue. Un agent conformité vérifie une règle. Un agent rédaction écrit la réponse.
Donnez à chaque exécutant une responsabilité unique et un contrat écrit. Une spécification structurée garde le développement de chaque agent indépendant. Le contrat énonce les entrées qu’il accepte et le format de sortie qu’il renvoie. Des contrats typés permettent d’échanger un agent contre un autre sans retester tout le système. Ils rendent aussi une étape en échec visible à la frontière où elle a eu lieu. Les contrats sont le moyen le moins coûteux d’explorer où un agent coordinateur perd de l’information.
Routage : comment une tâche atteint le bon agent
Le routage décide quel agent reçoit une demande. Le routage déterministe s’appuie sur des règles et des files d’attente. Une demande étiquetée comme remboursement part toujours vers l’agent remboursement. Le routage par modèle laisse un modèle de langage lire la demande et choisir l’agent. Le premier est prévisible et peu coûteux. Le second absorbe les demandes floues mais ajoute un appel de modèle et une nouvelle source d’erreur. Chaque approche doit prévoir un chemin par défaut quand aucun agent ne correspond.
La plupart des systèmes en production mêlent les deux. Les règles acheminent les cas courants et une voie par modèle traite le reste. Journalisez chaque décision de routage avec son motif. Un mauvais routage est le premier endroit où regarder quand une réponse s’écarte de ce que l’utilisateur demandait.
État partagé et mémoire entre agents
Des agents qui ne voient pas les mêmes faits se contredisent. L’état partagé est le registre de la tâche que chaque agent peut lire et mettre à jour. Il contient l’objectif, les décisions déjà prises et les résultats obtenus jusque-là. La mémoire ajoute ce qui persiste au-delà d’une exécution, comme les préférences d’un client ou l’historique des conversations antérieures. La persistance repose en général sur une base de données et souvent sur la recherche vectorielle pour les documents longs. La qualité de la restitution est une caractéristique à tester car les erreurs de recherche atteignent tous les agents en aval. Les équipes appellent cela la génération augmentée par restitution ou RAG. La bonne pratique consiste à journaliser la source utilisée par chaque réponse.
Gardez l’état à l’extérieur des agents. Stockez-le dans une couche persistante avec des versions et des points de reprise. Le même contexte partagé permet à chaque agent de lire les mêmes faits en temps réel. Si un exécutant tombe, l’orchestrateur restaure le dernier point de reprise au lieu de relancer la tâche. Un contexte transmis seulement par les prompts se perd à la première défaillance et dérive à mesure que la conversation s’allonge.
Politiques de passation : ce qui doit voyager avec le travail
Une passation transfère le contrôle d’un agent à un autre ou à une personne. La partie réceptrice a besoin de plus que le dernier message. Une politique saine définit la charge utile :
- l’objectif de la tâche et ce qui est déjà fait
- l’état partagé pertinent et sa version
- les droits d’accès que l’agent récepteur peut utiliser
- l’identifiant de trace qui relie la nouvelle étape à la précédente
Ajoutez une règle de refus. L’agent récepteur doit pouvoir déclarer qu’il ne peut pas prendre la tâche et la renvoyer avec un motif. Sans cette règle une boucle de passation peut tourner jusqu’à épuisement du budget.
Communication inter-agents : MCP pour les outils et A2A pour les agents
Deux protocoles ouverts normalisent la façon dont les agents se connectent. MCP, le Model Context Protocol, relie un agent aux outils et aux sources de données. En décembre 2025 la Linux Foundation a créé l’Agentic AI Foundation avec MCP parmi ses projets fondateurs. A2A, le protocole Agent2Agent, relie un agent à un autre. Il est devenu un projet de la Linux Foundation en juin 2025 et a atteint la version 1.0 en mars 2026, avec plus de 150 organisations de soutien recensées à son premier anniversaire en avril 2026.
En résumé, MCP porte l’appel d’un agent vers un outil tandis qu’A2A porte la tâche entre agents. Un système multi-agents peut employer les deux. Les standards réduisent le code de liaison sur mesure et les intégrations logicielles mais ne remplacent ni l’état ni le contrôle d’accès. La communication inter-agents réclame toujours des règles sur qui peut appeler quoi. Notre article sur MCP et A2A pour la recherche IA en entreprise couvre le détail des protocoles.
L’humain dans la boucle : dedans, au-dessus ou dehors
Trois postures décrivent la place des personnes. Une personne dans la boucle approuve chaque action conséquente avant son exécution. Une personne au-dessus de la boucle supervise et peut interrompre. Une personne hors de la boucle examine les résultats après coup par les pistes d’audit.
Choisissez par action et non par système. Lire un catalogue n’exige aucune approbation. Envoyer un devis engageant peut en exiger une. Définissez des points d’approbation pour les actions à haut risque et donnez aux approbateurs leurs propres droits d’accès. Chaque décision d’ humain dans la boucle a sa place dans la trace, à côté des décisions des agents.
Schémas d’orchestration : centralisé, décentralisé, hiérarchique et au-delà
Orchestration centralisée avec un agent gestionnaire
Dans l’ orchestration centralisée un agent gestionnaire reçoit la demande et répartit le travail vers des spécialistes. Il fusionne ensuite les réponses. Ce schéma offre la piste d’audit la plus claire et la gouvernance la plus directe, car chaque décision passe par un point unique.
Ce même point est sa faiblesse. Un point unique de défaillance limite le débit et un gestionnaire défaillant affecte toutes les tâches. Employez l’orchestration centralisée quand l’auditabilité compte plus que la montée en charge brute, car l’architecture reste gérable à exploiter. Ajoutez un gestionnaire de repli ou une politique de redémarrage pour qu’une panne n’arrête pas le flux.
Orchestration décentralisée et fédérée
Dans l’orchestration décentralisée les agents se coordonnent entre pairs, sans gestionnaire. Ils négocient qui prend une tâche et partagent les résultats directement. Le dispositif résiste à la perte d’un nœud mais les conflits exigent des règles de résolution explicites. Deux agents qui revendiquent la même tâche peuvent dupliquer le travail ou se bloquer mutuellement.
L’orchestration fédérée relie des systèmes distincts qui conservent leurs propres données. Chaque organisation fait tourner ses agents et n’expose que ce que l’échange exige. Elle convient aux cas où la confidentialité ou les contrats interdisent de mutualiser l’information dans un environnement distribué. Attendez-vous à plus de travail d’intégration et à une coordination plus lente qu’à l’intérieur d’une seule organisation.
Orchestration hiérarchique
L’orchestration hiérarchique étage la délégation. Un orchestrateur de premier niveau découpe un objectif en domaines et confie chaque domaine à un sous-orchestrateur. Chaque sous-orchestrateur pilote ses propres exécutants. La structure reproduit une entreprise déjà organisée en directions dotées de leurs règles.
Elle monte mieux en charge qu’un gestionnaire unique car aucun agent ne suit tous les exécutants. Le pilotage de chaque domaine reste local. Le coût tient à des passations plus nombreuses et à davantage d’endroits où le contexte peut s’amenuiser. Limitez la profondeur à deux ou trois niveaux et transmettez l’objectif intact à chaque passation.
Orchestration séquentielle et concurrente
L’orchestration séquentielle enchaîne les agents dans un ordre figé. Chacun s’appuie sur la sortie du précédent. Elle convient aux traitements par étapes comme rédaction puis relecture puis validation. Évitez-la quand les erreurs précoces se propagent ou quand une étape peut s’exécuter sans attendre.
L’orchestration concurrente envoie la même tâche ou des sous-tâches indépendantes à plusieurs agents en même temps et agrège les résultats. Elle réduit la latence et apporte plusieurs points de vue. Évitez-la quand les agents ont besoin des sorties les uns des autres ou quand la fusion de réponses contradictoires n’obéit à aucune règle claire. La concurrence multiplie aussi la consommation de jetons au même instant.
Orchestration en discussion de groupe et orchestration magentique
L’orchestration en discussion de groupe place plusieurs agents dans une conversation partagée sous l’autorité d’un animateur. Un agent producteur propose et un agent contrôleur critique, en boucle. Cela fonctionne pour les tâches de relecture où la discussion améliore le résultat. Plafonnez le nombre de tours ou la conversation ne se terminera pas.
L’orchestration magentique vise les problèmes ouverts dont le plan est inconnu. Un agent gestionnaire construit une liste de tâches et attribue les éléments à des spécialistes. Il révise le plan à mesure que les résultats arrivent. C’est le schéma le plus souple, le plus lent et le plus coûteux à exécuter.
Orchestration par passation
L’orchestration par passation laisse l’agent actif décider qu’un autre agent doit prendre le relais. Un agent de tri reçoit la demande et la transmet au spécialiste qui convient. Le spécialiste peut la transmettre à son tour. Le contrôle se déplace avec le contexte et aucun gestionnaire ne siège au-dessus.
Ce schéma convient aux parcours clients où le bon expert ne se révèle qu’en cours de conversation. Il convient aussi au transfert vers un conseiller humain. Son risque est une boucle de passation entre deux agents. Fixez un nombre maximal de transferts et journalisez chacun d’eux.
Comment choisir un schéma
Choisissez le schéma d’orchestration d’après la forme de la tâche et le contrôle qu’il vous faut. Commencez par l’option la plus sobre qui fonctionne et n’ajoutez de la structure que lorsqu’un test révèle un manque. Chaque approche de la coordination de plusieurs agents présente un profil de coût généralement différent.
Exploiter l’orchestration en production : défaillances, observabilité, sécurité et coût
Pourquoi les systèmes multi-agents échouent : 14 modes en trois familles
Une étude intitulée « Why Do Multi-Agent LLM Systems Fail? », de Cemri et ses coauteurs, donne la meilleure cartographie du problème. Les auteurs ont analysé plus de 1 600 traces annotées issues de 7 cadres multi-agents. Ils ont défini 14 modes de défaillance en trois familles : les défauts de conception du système, le désalignement entre agents et la vérification des tâches. Leur taxonomie s’appelle MAST et les annotateurs s’accordaient avec un kappa de 0,88.
Chaque famille désigne un contrôle que la couche d’orchestration peut prendre en charge. Les défauts de conception appellent des contrats et des conditions d’arrêt claires. Le désalignement appelle une mémoire partagée et des charges utiles de passation explicites. Une vérification faible appelle un agent contrôleur ou un point d’approbation humaine. Les équipes qui traitent ces défaillances au niveau de l’orchestration évitent de rapiécer chaque agent séparément. Traitez chaque signalement de défaillance comme un événement dont la cause racine appartient à l’une des trois familles.
Le saviez-vous ?
La taxonomie montre que de nombreuses défaillances viennent de la coordination et non de l’intelligence du modèle. Un modèle plus puissant ne répare pas un historique de conversation perdu.
Reprise sur défaillance : réessais, points de reprise et limites d’arrêt
Planifiez la reprise sur défaillance avant le premier déploiement. Une étape en échec doit être réessayée avec la même entrée et produire le même effet. Chaque réessai est un événement que la trace doit consigner. Cette propriété s’appelle l’idempotence. Un appel de paiement exécuté deux fois est un défaut, une consultation exécutée deux fois est sans conséquence.
Enregistrez des points de reprise après chaque étape achevée, pour qu’un redémarrage reprenne au lieu de refaire le travail. Définissez un agent de repli ou un repli vers une personne quand les réessais échouent. Fixez un plafond ferme d’itérations et un chien de garde qui détecte les blocages de coordination. Un agent qui ne peut pas aboutir doit s’arrêter et le signaler au lieu de boucler.
Observabilité : traces, métriques et pistes d’audit
On ne répare pas ce qu’on ne voit pas. L’observabilité d’un système multi-agents, c’est une trace unique qui suit une tâche à travers chaque agent et chaque appel d’outil. La trace consigne quel agent a agi, quel contexte il a reçu et ce qu’il a renvoyé.
Ajoutez des métriques de latence, de taux de réussite et de consommation de jetons par agent. Tenez une piste d’audit difficile à altérer, pour qu’un relecteur puisse reconstituer qui a décidé quoi. Ce registre sert au débogage et à la revue de conformité. Il permet aussi de comparer deux versions d’un agent sur le même trafic. Les rapports d’exploitation bâtis sur les traces montrent quels processus coûtent le plus. Les processus d’incident et les processus de conformité dépendent des mêmes registres.
Sécurité : moindre privilège par agent
Chaque agent ne doit détenir que les permissions nécessaires à sa tâche. C’est le principe du moindre privilège. Il compte davantage avec plusieurs agents, car un agent compromis atteint tout ce qui lui est permis d’atteindre. Donnez à chaque agent ses propres identifiants et faites-les tourner. Les développeurs qui écrivent le code des agents et les équipes de support qui les exploitent ne doivent jamais partager un même identifiant.
Chiffrez le trafic entre agents et restreignez les outils que chacun peut appeler. Traitez le contenu que les agents se transmettent comme une entrée non fiable et évaluez-le avant qu’il n’atteigne un outil. Rendez les permissions explicites dans l’infrastructure et pas seulement dans les prompts. Un document porteur d’instructions cachées ne doit pas pouvoir orienter l’agent suivant. Masquez les champs sensibles avant tout appel à un fournisseur de modèle externe.
Gouvernance et règlement européen sur l’IA
Pour les systèmes à haut risque, le règlement (UE) 2024/1689 impose une journalisation automatique des événements à l’article 12 et un contrôle humain à l’article 14. L’annexe III énumère des domaines comme l’évaluation des risques et la tarification en assurance vie et santé. Une couche d’orchestration qui touche à ces décisions doit tracer chaque agent et offrir un moyen d’intervention à une personne.
Concevez ces contrôles une seule fois, au niveau de l’orchestration. Vérifiez les dates d’application en vigueur avec votre équipe juridique, car le calendrier a été modifié depuis l’adoption du règlement. Au regard du règlement européen sur l’IA une trace est un actif de conformité et pas seulement un outil de débogage.
Maîtrise des coûts : budgets de jetons et plafonds
Le constat d’Anthropic, selon lequel la consommation de jetons explique l’essentiel de la variance de performance, coupe dans les deux sens. Plus de jetons peut améliorer les résultats et alourdit aussi la facture. Fixez un budget de jetons par agent et par exécution. Plafonnez le nombre d’appels de modèle et arrêtez automatiquement les exécutions qui s’emballent.
Acheminez les étapes routinières vers des modèles plus petits et réservez le modèle le plus puissant aux décisions difficiles. Les factures d’infrastructure cloud augmentent avec l’échelle et l’usage, donc chaque service ajouté doit justifier son coût. Mesurez le coût par tâche achevée et non par appel. Un système qui réessaie en silence peut paraître économique à l’appel et rester cher au résultat.
Du pilote à la production : un chemin de mise en œuvre
Passez du pilote à la production en quatre étapes :
- Choisissez un flux de travail à forte valeur, doté d’une mesure de réussite claire.
- Énumérez les agents et rédigez une matrice de responsabilités avec les entrées et les sorties.
- Construisez un prototype minimal qui émet une trace complète.
- Faites tourner le pilote sur du trafic réel et collectez des métriques avant d’ajouter des agents.
Conseil d’expert :
N’ajoutez le deuxième agent que lorsque vous pouvez nommer la défaillance qu’un agent seul n’a pas su résoudre. Chaque agent ajouté doit avoir un motif écrit et un résultat mesuré. Inscrivez les exigences de montée en charge dans le plan de pilote : volume attendu, cibles de latence et ressources nécessaires à l’exploitation.
Cadres et outils : ce qu’ils couvrent et où ils s’arrêtent
Des cadres libres comme LangGraph, CrewAI et le SDK Agents d’OpenAI donnent aux développeurs des briques pour le routage, l’état et la passation. Des services cloud comme Amazon Bedrock et les services d’agents de Microsoft hébergent les mêmes idées en offres gérées. Leurs fonctionnalités couvrent des capacités telles que le stockage d’état et les intégrations d’outils. Surveillez l’enfermement propriétaire quand vos flux d’agents dépendent d’un seul service. Un cadre d’orchestration répond à la question de la coordination des agents.
Il ne fournit ni votre modèle de données métier, ni vos règles d’approbation, ni votre politique d’audit. Votre équipe les écrit par-dessus et prévoit le code et les ressources pour les maintenir. Pour comparer les couches au-delà de l’orchestration, comme les passerelles de modèles et les modèles de tarification, lisez notre guide d’une plateforme d’agents IA. Choisissez un cadre quand vos ingénieurs veulent la maîtrise complète et acceptent la maintenance qui va avec. Testez le comportement du système en charge et générez du trafic réaliste avant le lancement. La bonne pratique consiste à conserver un plan de sortie explicite, pour que les choix d’infrastructure ne deviennent pas un enfermement.
La place de Kleio : orchestrer un parcours d’achat à forte valeur
Un parcours d’achat, quatre agents et un conseiller humain
Kleio applique l’orchestration d’agents aux ventes complexes et à forte valeur, comme l’immobilier, le voyage et la distribution automobile. Dans ces parcours l’acheteur sait rarement quoi demander. Un agent de découverte qualifie le besoin. Un agent produit raisonne sur le catalogue. Un agent devis ou financement construit l’offre. Un agent de prise de rendez-vous réserve le créneau. Une passation finale envoie l’acheteur vers un conseiller humain avec le contexte enrichi.
À chaque passation, le schéma montre ce qui voyage : l’état partagé, les droits d’accès de l’agent suivant et la trace. Il montre aussi quel standard s’applique. MCP relie les agents aux outils et aux données. A2A relie les agents entre eux. UCP expose le catalogue aux assistants IA.
État et mémoire partagés par trois magasins spécialisés
Les agents ci-dessus lisent les mêmes faits métier. Le Knowledge Engine de Kleio répartit un catalogue sur trois magasins spécialisés pour le contenu produit, documentaire et mémoire. Le magasin de mémoire conserve le contexte de chaque conversation, pour que l’agent suivant ne reparte pas de zéro.
Une couche séparée porte la configuration et la gouvernance. Cette conception répond au problème d’état partagé décrit plus haut par un modèle de données métier et non par un simple tampon générique. Chaque secteur a son ontologie propre, car le voyage n’est pas l’automobile et l’immobilier n’est pas le négoce. Voyez la plateforme Kleio pour la pile complète.
Contrôle d’accès et configurations versionnées par opération
Kleio applique un RBAC par opération pour que chaque agent n’ait que les droits nécessaires à son opération. Les configurations d’agents sont versionnées. Un changement peut donc être tracé et annulé. Les champs sensibles sont pseudonymisés dans le flux avant tout appel à un fournisseur de modèle externe.
La plateforme est isolée par locataire et conforme SOC 2 . Ces contrôles correspondent aux familles de défaillances ci-dessus. Les configurations versionnées soutiennent la reprise et les droits par opération limitent l’effet d’un agent défaillant. Une équipe des risques peut examiner la trace même dont les ingénieurs se servent pour déboguer.
Orpi : une orchestration en ligne dans 1 250 agences
Orpi, réseau immobilier français, fait tourner la plateforme sur orpi.com et dans chacune de ses 1 250 agences pour 8 000 conseillers. Son directeur général Guillaume Martinaud a décrit le résultat :
« [...] la plateforme est en ligne, sur Orpi.com et dans chacune de nos 1 250 agences. »
Ce propos vient du client et non d’une promesse de Kleio. Il montre des agents en fonctionnement sur un parcours d’achat complexe, avec des conseillers dans la boucle. Lisez l’ étude de cas Orpi pour le récit complet.
Quand Kleio n’est pas le bon choix
Kleio n’est ni un cadre d’orchestration libre, ni un modèle de langage généraliste. Ce n’est pas un outil en libre-service et il n’existe aucune formule gratuite. Le déploiement est accompagné par l’équipe Kleio, pour de grandes entreprises aux ventes complexes et à forte valeur.
Si vos ingénieurs veulent construire et maîtriser chaque couche pour un flux interne, un cadre convient mieux. Si vos agents doivent raisonner sur un grand catalogue et qu’une équipe des risques doit les valider, une couche d’orchestration verticale mérite sa place dans votre présélection. Apportez un parcours réel à la première démonstration.